출처 20곳달린 조사보고서를 AI가쓴다면
프로용© AIKOREACLUBassafelovic/gpt-researcher
출처 20곳 달린 조사 보고서를 AI가 쓴다면
질문 하나를 여러 하위 질문으로 쪼개 웹과 내 문서에서 스무 곳 넘는 출처를 모으고, 인용이 달린 긴 조사 보고서를 PDF·워드로 써 주는 오픈소스 에이전트예요
시장 조사든 논문 배경 조사든, 검색 탭을 서른 개 열어 놓고 복사해 붙이다 보면 하루가 가요. 챗봇에 물으면 빠르긴 한데 그럴듯한 답에 출처가 없고, 있어도 눌러 보면 없는 글일 때가 있죠.GPT Researcher는 질문을 받으면 먼저 하위 질문 여러 개로 쪼개고, 질문마다 웹을 뒤져 스무 곳 넘는 출처를 모은 뒤, 인용이 달린 2,000단어 넘는 보고서를 써요. README는 '웹과 내 문서를 함께 조사하는 첫 오픈소스 심층 조사 에이전트'라고 소개해요. 깃허브 별 3만 개, 중국어·일본어·한국어·러시아어 README가 따로 있을 만큼 널리 쓰여요.
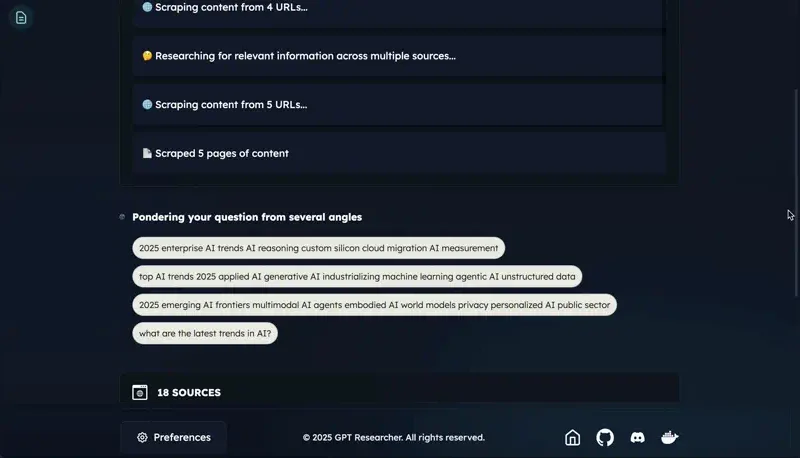
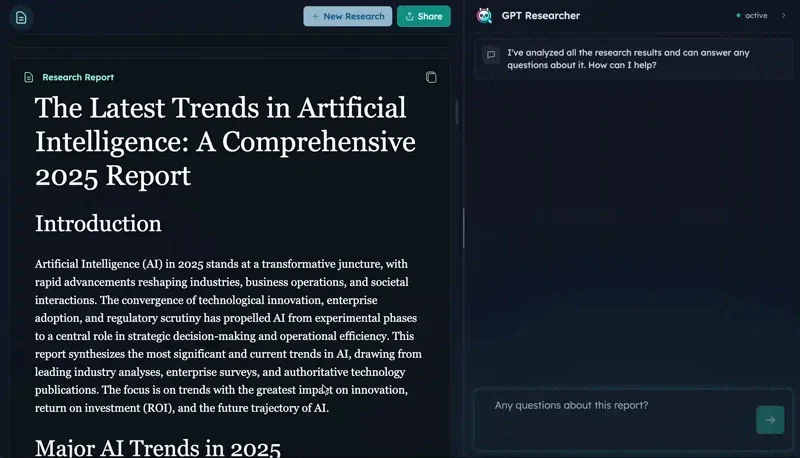
README의 데모 영상에서 두 장면을 골랐어요. 왼쪽은 '최근 AI 동향이 뭐야?'라는 질문을 네 개의 검색어로 쪼개고 출처 18곳을 모으는 중이고, 오른쪽은 그 결과로 나온 보고서의 첫 부분이에요. 오른쪽 대화창에서는 완성된 보고서를 놓고 이어서 물어볼 수 있어요.이미지: assafelovic/gpt-researcher README 데모 영상(Apache-2.0)
챗봇 답과 조사 보고서, 무엇이 다른가
- [1]환경부 무공해차 통합누리집 · 충전기 설치 현황 통계 ev.or.kr/... 열어서 확인
- [2]친환경자동차법 시행령 개정 안내 · 법제처 law.go.kr/... 열어서 확인
- [3]관계부처 합동 보도자료 · 전기차 충전 인프라 확충 계획 korea.kr/... 열어서 확인
README의 '왜 만들었나' 항목과 데모 영상의 보고서 모양을 보여 주려고 저희가 그린 예시예요. 질문과 답, 출처 목록은 지어낸 것이고, 실제 챗봇의 답은 서비스마다 달라요.
한눈에
무엇인가요
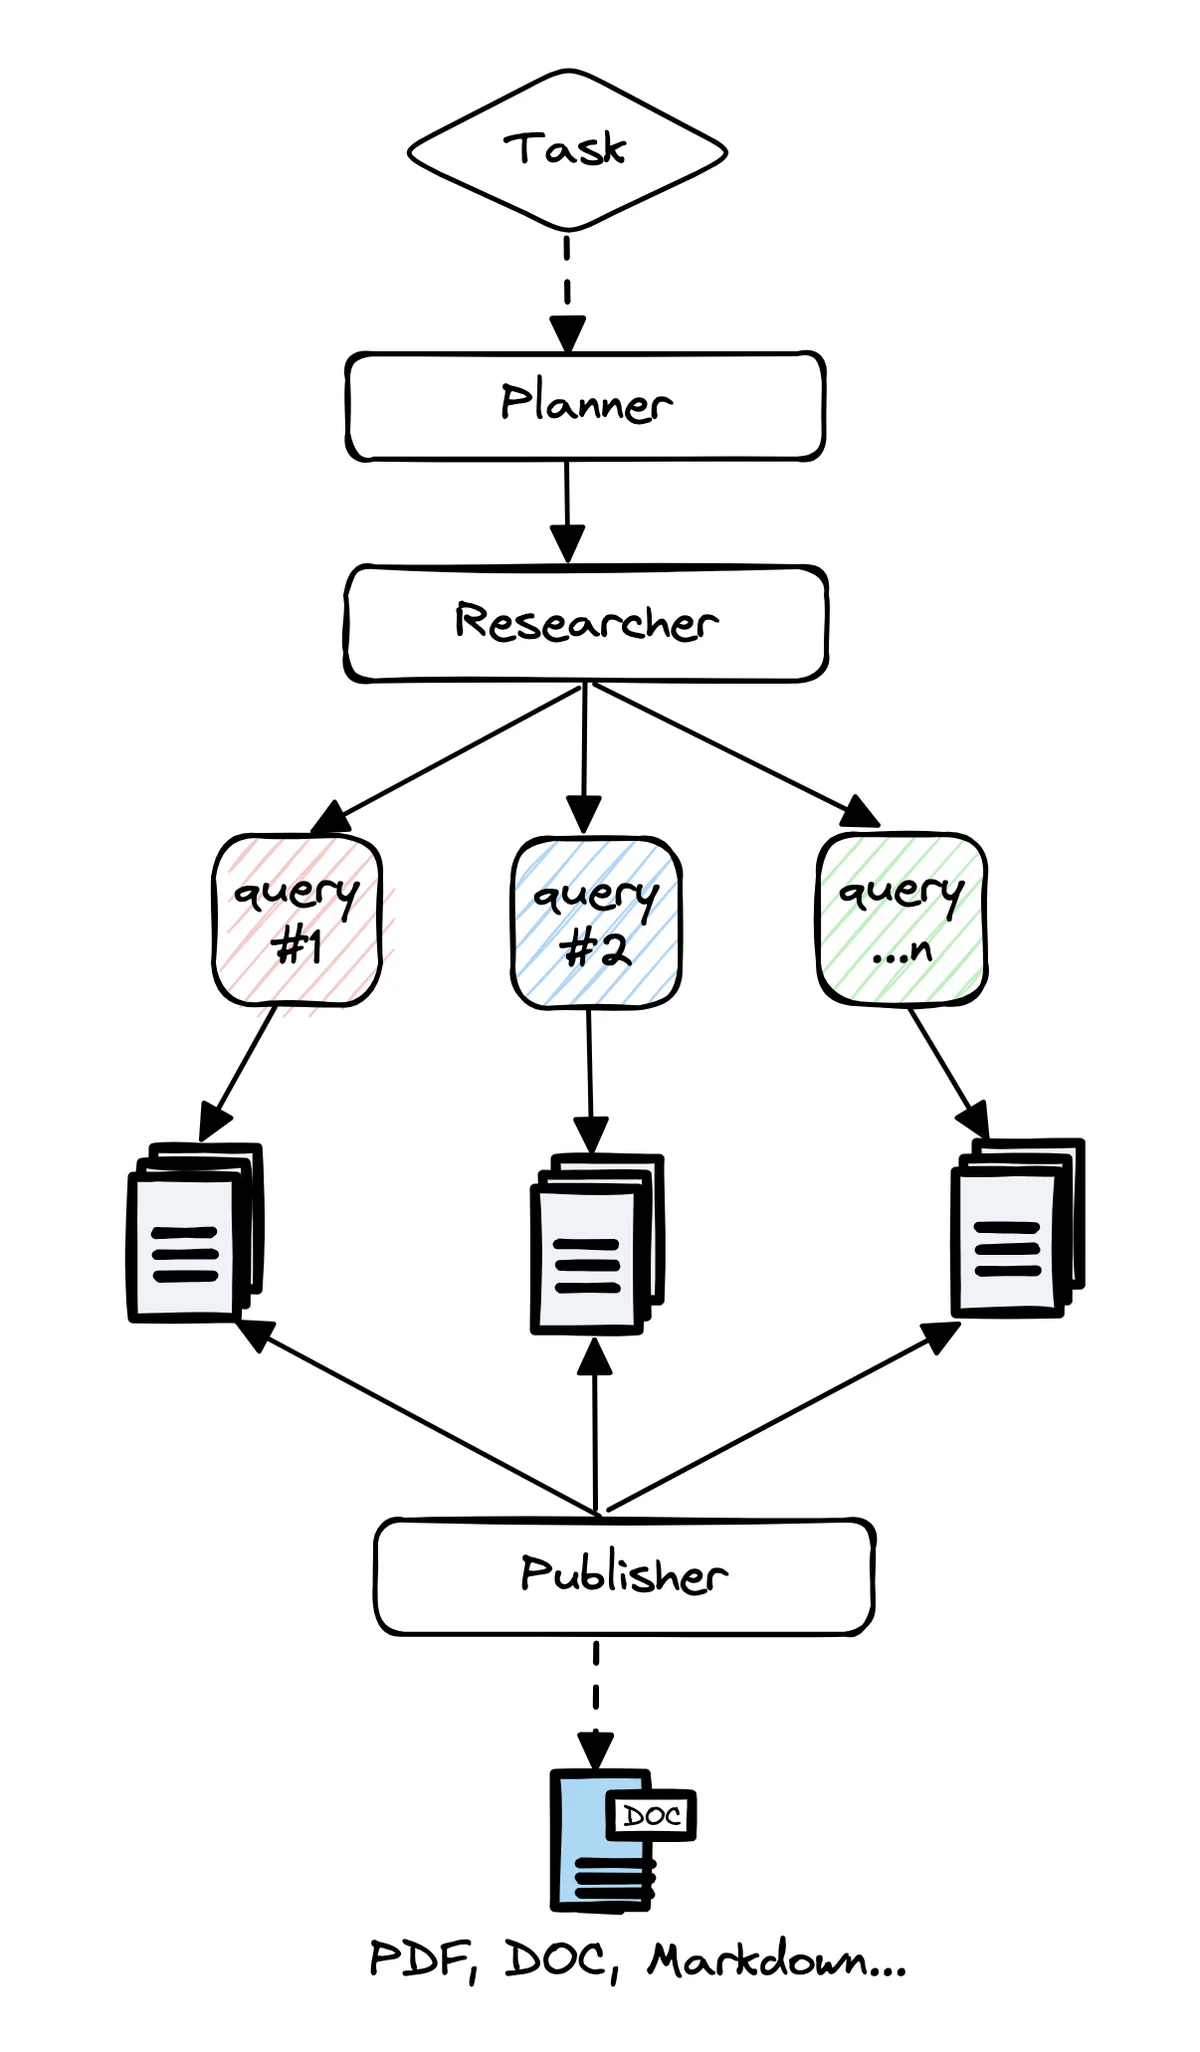
GPT Researcher는 '계획하는 에이전트'와 '실행하는 에이전트', 그리고 '펴내는 에이전트'로 나뉘어 일해요. 계획 에이전트가 조사 질문을 만들고, 실행 에이전트들이 질문마다 자료를 긁어 오고, 펴내는 에이전트가 모아서 보고서로 묶어요.어디서 찾나. 기본은 Tavily 검색 API예요. 덕덕고·구글·빙·브레이브 같은 일반 검색, arXiv·OpenAlex·Semantic Scholar·PubMed Central 같은 학술 검색, MCP로 붙인 깃허브·데이터베이스까지 검색기를 바꾸거나 쉼표로 여러 개를 섞을 수 있어요. DOC_PATH 폴더를 지정하면 내 PDF·워드·엑셀·파워포인트·CSV·마크다운 문서도 조사 대상이 돼요.무엇이 나오나. 보고서 종류는 일반 조사 보고서, 자료 목록 보고서, 개요 보고서, 그리고 '심층 조사'(deep)예요. 심층 조사는 질문을 나무처럼 가지 쳐 가며 파고드는데, README 기준 한 번에 약 5분, 약 0.4달러(o3-mini 높은 추론 기준)가 들어요. 결과는 마크다운, PDF, 워드로 내보내요.걸러 내기. 긁어 온 수십 쪽 가운데 질문에 쓸모 있는 단락만 남기는 문맥 필터가 있어요. 기본은 Jev 모델(TYPESAFE_API_KEY 필요)이고, 키가 없으면 키워드 방식(BM25)으로 내 컴퓨터에서 돌아요.스무 곳을 긁어 가장 자주 나오는 정보를 고르면 전부 틀릴 가능성이 낮아진다는 게 README가 밝힌 설계 생각이에요. 다만 편향을 없애는 게 아니라 줄이는 게 목표라고도 적어요.
함께 쓰는 도구 · 파이썬 3.12 이상 · OpenAI(기본) 등 여러 모델 · Tavily(기본)·덕덕고·구글·arXiv 등 검색기 · 도커 · 클로드 코드(스킬) · 클로드 데스크톱(MCP 서버, 별도 저장소)
이런 분께
- 경쟁사·시장·정책 동향을 출처와 함께 정리해 보고해야 하는 기획·마케팅 담당
- 논문 배경 조사나 선행 연구 목록을 빠르게 훑고 싶은 대학원생·연구자
- 내 회사 문서와 웹 자료를 한데 놓고 조사 보고서를 자동으로 뽑고 싶은 개발자
어떻게 작동하나요
1. 질문을 쪼개요. 조사 질문을 받으면 계획 에이전트가 하위 질문을 여러 개 만들어요. 데모 영상에서는 '최근 AI 동향'이라는 한 줄 질문이 네 갈래 검색어로 나뉘어요.2. 질문마다 자료를 긁어요. 검색기에서 질문당 결과 5개(MAX_SEARCH_RESULTS_PER_QUERY 기본값)를 받아 본문을 긁고, 각 자료를 요약하면서 출처를 기록해요. 검색 다듬기는 기본 3번(MAX_ITERATIONS)까지 돌아요.3. 쓸모 있는 단락만 남겨요. 긁어 온 글 가운데 질문에 답이 되는 단락만 문맥 필터가 골라요. README 벤치마크(조사 과제 28개)에서 Jev 필터는 남긴 단락의 73%가 관련 있었고, 임베딩 방식은 46%였어요.4. 보고서를 써요. 본문 작성은 SMART_LLM(기본 gpt-5.4), 요약은 FAST_LLM(기본 gpt-5.4-mini)이 맡아요. 인용 형식은 APA가 기본이고 MLA·IEEE 등으로 바꿀 수 있어요. 보고서 언어는 LANGUAGE 설정으로 정하는데 기본값은 영어예요.출처 스무 곳을 모았다고 다 맞는 건 아니에요. 보고서에 달린 링크는 꼭 열어 보고 쓰세요. README 자체가 '실험적인 도구이며 학술 논문에 쓰라는 권고가 아니다'라고 밝혀요.
바로 쓸 수 있나요
필요한 것파이썬 3.12 이상, 터미널, OpenAI API 키와 Tavily API 키(기본값. 다른 모델·검색기로 바꿀 수 있어요). 도커로도 띄울 수 있어요
비용저장소는 무료(Apache-2.0). 조사할 때마다 모델·검색 API 요금이 들어요. README 기준 심층 조사 한 번 약 0.4달러(o3-mini), 일반 보고서는 벤치마크에서 약 0.12~0.19달러
시작하기
- 파이썬 3.12 이상 준비
README가 요구하는 최소 버전이에요.
- 저장소 받기
내려받은 폴더로 들어가요.
git clone https://github.com/assafelovic/gpt-researcher.git && cd gpt-researcher - API 키 넣기
기본값은 OpenAI 모델과 Tavily 검색이에요. 터미널에 내보내거나 .env 파일에 적어요. 다른 OpenAI 호환 API(로컬 모델 등)는 OPENAI_BASE_URL 로 바꿔요.
export OPENAI_API_KEY={Your OpenAI API Key here} export TAVILY_API_KEY={Your Tavily API Key here} - 설치하고 띄우기
끝나면 브라우저에서 http://localhost:8000 을 열어요.
pip install -r requirements.txt python -m uvicorn main:app --reload - 코드에서 쓰려면 패키지로
파이썬 코드에서 GPTResearcher(query=...) 로 부르고 conduct_research() 뒤 write_report() 를 호출해요.
pip install gpt-researcher - 도커가 편하면
.env.example 을 복사해 키를 넣고 실행하면 파이썬 서버(8000)와 리액트 화면(3000)이 함께 떠요.
docker compose up --build
why is Nvidia stock going up?
README의 파이썬 예시에 나오는 첫 질문이에요. 한국어로 물어도 되는지는 README에 적혀 있지 않지만, 공식 문서의 LANGUAGE 설정으로 보고서 언어를 정할 수 있고 한국어 README도 따로 있어요.처음 쓰는 순서
API 키 두 개 준비OpenAI 키와 Tavily 키를 .env 에 넣어요(기본값 기준)웹 화면으로 첫 조사uvicorn 으로 띄우고 localhost:8000 에서 질문 한 줄출처 링크 열어 보기보고서의 인용을 하나씩 눌러 원문이 그 말을 하는지 확인내 문서 보태기DOC_PATH 에 PDF·워드를 넣고 Report Source 를 바꿔 다시필요하면 심층 조사report_type 을 deep 으로. 시간과 비용이 더 들어요
README와 공식 문서의 명령을 처음 쓰는 순서로 묶은 예예요.
질문 하나가 보고서가 되기까지
README와 공식 문서(구조, 문맥 필터, 심층 조사, 설정)에 적힌 단계와 기본값을 따라 저희가 그린 예시예요. 질문·검색어·출처·보고서 문장은 지어낸 것이고, 실제 결과는 고른 모델·검색기와 그날의 웹에 따라 달라져요.
명령어 전체 10개, 언제 쓰나
보고서 종류(report_type)
research_report- 일반 조사 보고서. 기본값
resource_report- 주제에 관한 자료 목록 보고서
outline_report- 글을 쓰기 전 개요 보고서
deep- 심층 조사. 너비 4·깊이 2로 가지를 뻗어 파고들어요
자주 바꾸는 설정(환경 변수)
RETRIEVER=tavily,openalex- 검색기 고르기·섞기. 학술 조사는 tavily,openalex,semantic_scholar 를 README가 예로 들어요
DOC_PATH=./my-docs- 내 문서 폴더. 웹 화면에서는 Report Source 를 My Documents 로
LANGUAGE=english- 보고서 언어. 기본값 영어
REPORT_FORMAT=APA- 인용 형식. MLA·IEEE 등으로 바꿀 수 있어요
TOTAL_WORDS=1200- 보고서 길이. 심층 조사는 2,000 이상을 권해요
CONTEXT_FILTER=auto- 문맥 필터. jev·keyword·embeddings·none 중 하나
공식 문서(파이썬 패키지, 설정, 심층 조사)에 나온 값 중 처음 쓸 때 손댈 만한 것만 골랐어요. 설정은 .env 파일이나 config.json 으로도 넣어요.
직접 띄우지 않고도 써요
README는 클로드 코드 안에서 심층 조사 기능을 쓸 수 있다고 적고, 스킬 문서는 이 스킬이 GPT Researcher의 구조·설정·API 지식을 클로드에게 알려 준다고 설명해요.
npx skills add assafelovic/gpt-researcher비슷한 도구
GPT Researcher는 밖에서 자료를 모아 보고서로 묶는 쪽이고, AnythingLLM은 내 문서 안에서 답하는 쪽, 과학 스킬 모음은 연구 절차를 코딩 AI에 가르치는 쪽이에요(각 README 기준).
주의할 점
- AI 보고서의 출처는 반드시 원문을 열어 확인하세요. README의 면책 조항은 이 도구가 실험적이며 '있는 그대로' 제공되고, 학술 논문이나 연구에 쓰라는 권고가 아니라고 밝혀요. 출처가 스무 곳이어도 그 출처들이 같은 오보를 받아 적었을 수 있어요.
- 기본값은 질문과 긁어 온 자료가 OpenAI와 Tavily 서버로 가요. 외부로 보내면 안 되는 문서를 DOC_PATH 에 넣기 전에, OPENAI_BASE_URL 로 로컬 모델을 붙이는 방법을 먼저 보세요.
- 웹 자료를 자동으로 긁어 와요. 긁는 사이트의 약관과 robots 규칙, 개인정보 규정은 쓰는 사람이 지켜야 해요. 보고서를 공개할 때는 인용한 글의 저작권도 따로 봐야 해요.
- 조사마다 API 요금이 들고, 심층 조사는 질문 수가 곱으로 늘어 비용과 시간이 더 커져요. 키는 .env 에만 두고 코드에 적지 마세요.
- 마지막 코드 반영이 2026년 10월 10일이에요(확인 2026-11-03). 공식 문서 기본 모델(gpt-5.4)과 README의 비용 예시(o3-mini)는 쓴 시점이 달라요.
더 보기
만든 사람은 Assaf Elovic이에요. 공식 사이트는 gptr.dev이고, 멀티 에이전트판은 LangGraph와 AG2 위에 만들어졌어요.
공식 문서 ↗한국어 README ↗심층 조사 설명 ↗문맥 필터 벤치마크 ↗MCP 서버 저장소 ↗깃허브 저장소 ↗
낯선 말
- 에이전트 · 목표를 받으면 스스로 검색·읽기·쓰기 단계를 밟아 끝까지 가는 AI 프로그램이에요
- 검색기(리트리버) · 자료를 어디서 찾을지 정하는 부품. Tavily, 덕덕고, arXiv 같은 것들이에요
- 스크래핑 · 웹페이지를 열어 본문을 자동으로 긁어 오는 일이에요
- 문맥 필터 · 긁어 온 글에서 질문에 쓸모 있는 단락만 골라 모델에 건네는 단계예요
- 환경 변수 · 프로그램 바깥에서 넣어 주는 설정값. API 키나 검색기 이름을 여기에 적어요
- APA · 학술 글에서 출처를 적는 형식 중 하나예요. (저자, 연도) 꼴이에요
- MCP · AI 앱이 외부 도구·자료에 같은 방식으로 연결하는 규격이에요
댓글
AI 답은 참고 자료예요. 법·세금·돈·건강처럼 삶에 큰 영향을 주는 일에서는 AI 답이 정답이 될 수 없어요. 최종 판단은 전문가나 공식 기관에서 확인하세요.

