원곡에서목소리만 빼고반주만 남길 수있을까
입문자용© AIKOREACLUBAnjok07/ultimatevocalremovergui
원곡에서 목소리만 빼고 반주만 남길 수 있을까
노래 파일을 넣으면 AI 분리 모델이 목소리와 반주를 따로 나눠 저장해 주는 무료 데스크톱 앱이에요. 드럼, 베이스, 기타처럼 악기별로도 나눠요
커버 영상을 찍거나 노래 연습을 하려는데 원곡 반주(MR)를 구할 수 없을 때가 있죠. 다 녹음된 노래는 목소리와 악기가 한 파일에 더해져 있어서, 볼륨이나 이퀄라이저를 만져서는 목소리만 깔끔하게 떼어 내기 어려워요.얼티밋 보컬 리무버(UVR)는 AI 분리 모델을 버튼 하나로 돌려 목소리와 반주, 드럼과 베이스를 각각 다른 파일로 꺼내 주는 무료 앱이에요. 2026-11-03 기준 별 2만 6천 개가 넘고, 10월 6일에는 만든 사람이 6주 안에 새 버전 UVR 6을 내겠다고 알렸어요.
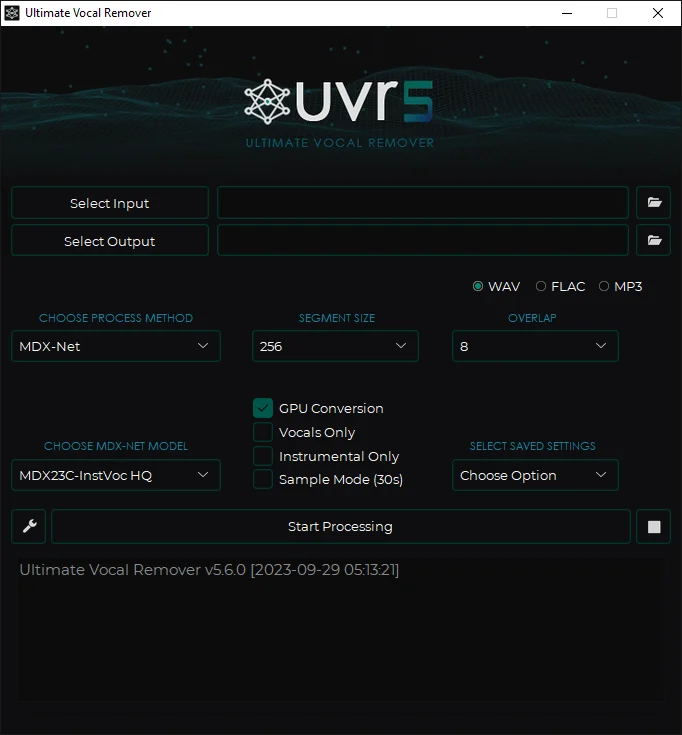
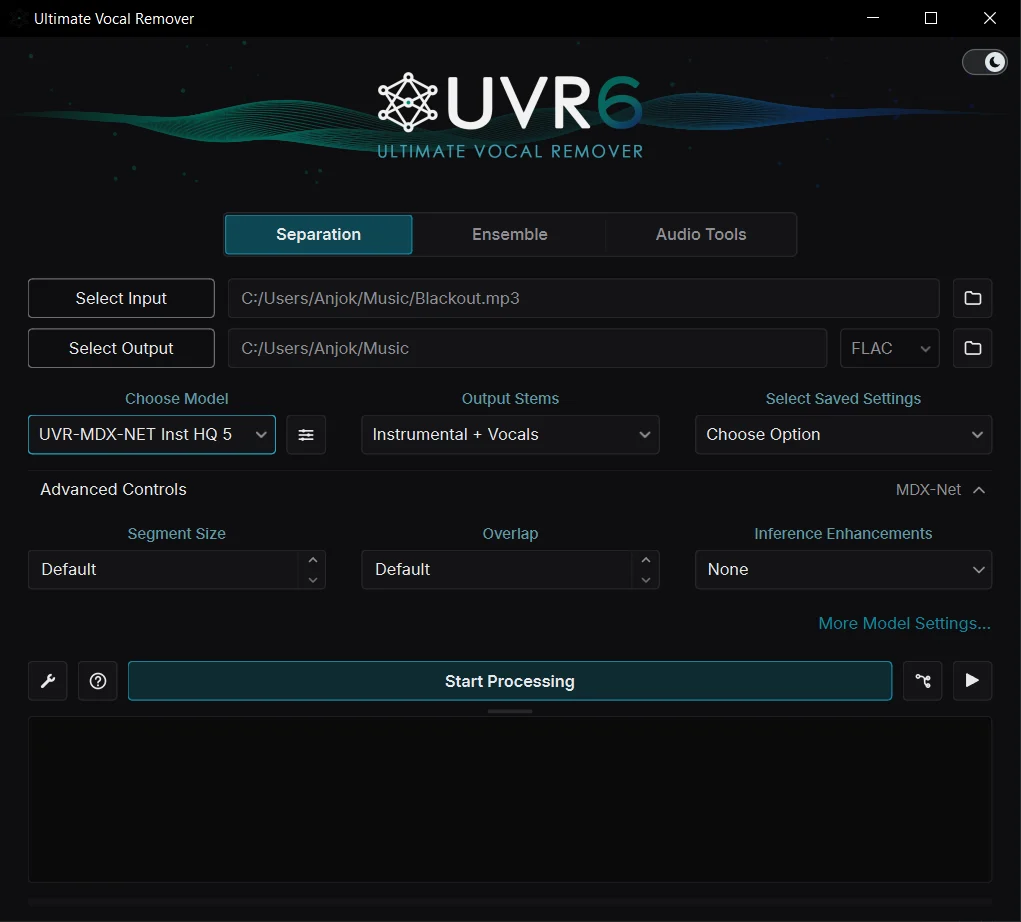
왼쪽은 README에 실린 5.6 화면이에요. 넣을 노래와 저장 폴더, 처리 방식(MDX-Net)과 모델(MDX23C-InstVoc HQ), WAV·FLAC·MP3 중 저장 형식, 그래픽카드 사용과 30초 맛보기(Sample Mode)가 한 화면에 있어요. 오른쪽은 10월 6일 개발 소식에 올라온 UVR 6 화면이에요. 분리, 앙상블, 오디오 도구가 위쪽 탭으로 나뉘고, 출력 갈래(Instrumental + Vocals)를 바로 고르게 바뀌었어요.이미지: Anjok07/ultimatevocalremovergui README, 이슈 2399 (MIT)
섞인 노래를 나누기 어려운 세 가지 이유
- 앙상블로 여러 모델 합치기
- 후처리로 남은 악기 소리 찾기
- 30초 맛보기로 모델 비교
- DeEcho-DeReverb 모델로 울림 걷기
- 리드와 코러스 따로 나누기
노래를 나눌 때 흔히 겪는 문제를 보여 주려고 저희가 그린 예시예요. 파형은 실제 소리가 아니고, 아래 선택지는 UVR 앱 안내에 적힌 옵션이에요. 실제 결과는 노래, 고른 모델, 설정에 따라 달라져요.
한눈에
무엇인가요
UVR은 노래 파일 하나를 넣으면 AI 분리 모델로 목소리(Vocals)와 반주(Instrumental)를 따로 저장해 주는 데스크톱 앱이에요. 설치 파일에 파이썬, 파이토치 같은 부품이 다 들어 있어서 따로 준비할 게 없다고 README가 적어요.분리 방식을 고를 수 있어요. VR Architecture, MDX-Net, Demucs 세 계열의 모델을 써요. Demucs로는 목소리, 드럼, 베이스, 나머지 네 갈래로 나누고, 6갈래 모델(htdemucs_6s)은 기타와 피아노까지 떼어 내요.여러 모델을 섞을 수 있어요. 앙상블 모드는 여러 모델의 결과를 합쳐 최종 파일을 만들어요. 가장 큰 값을 남기는 Max Spec, 가장 작은 값을 남기는 Min Spec, 평균(Average) 중에서 골라요.모델 대부분을 직접 학습시켰어요. Demucs v3, v4의 4갈래 모델을 빼면 앱에 든 모델은 UVR 핵심 개발자들이 학습시킨 것이라고 밝혀요.
함께 쓰는 도구 · 윈도 10 이상 · macOS Big Sur 이상 · 리눅스(데비안·아치 계열) · 엔비디아 그래픽카드(선택) · FFmpeg · Rubber Band
이런 분께
- 커버 영상이나 노래 연습에 쓸 원곡 반주(MR)가 필요한 분
- 보컬이나 드럼, 베이스만 따로 들으며 따라 배우고 싶은 연주자와 가수 지망생
- 영상 소리에서 말소리만, 또는 음악만 따로 남기고 싶은 크리에이터
어떻게 작동하나요
모델은 앱 안에서 내려받아요. Start Processing 왼쪽의 설정 버튼에서 다운로드 센터를 열어 쓸 모델을 받고, 처리 방식과 모델을 고른 뒤 Start Processing 을 눌러요. 결과는 노래이름_(Vocals).wav, 노래이름_(Instrumental).wav 처럼 갈래 이름이 붙은 파일로 저장돼요.그래픽카드가 있으면 빨라요. GPU Conversion 을 켜면 그래픽카드로 계산해요. 엔비디아 GTX 1060 6GB가 최소이고 8GB 이상을 권해요. M1 맥은 Demucs v4와 MDX-Net 모델에서 MPS 가속을 써요. 변환 시간은 컴퓨터 성능에 크게 좌우되고, 모델들이 계산을 많이 쓴다고 README가 분명히 적어요.한 곡 전체를 돌리기 전에 맛보기. Sample Mode 를 켜면 30초 분량만 처리해서 모델과 설정을 빠르게 비교할 수 있어요. 메모리 오류가 나면 Segment 나 Window 크기를 낮추라고 해요.목소리를 한 번 더 다듬는 선택지. 목소리 결과를 리드와 코러스로 나누는 옵션과 울림을 걷어 내는 옵션이 있어요. 두 옵션 모두 지금은 앙상블 모드에서는 안 된다고 앱 안내에 적혀 있어요.
할 수 있는 일
바로 쓸 수 있나요
필요한 것윈도 10 이상이나 macOS Big Sur 이상의 64비트 컴퓨터. 엔비디아 그래픽카드(최소 GTX 1060 6GB, 8GB 이상 권장)가 있으면 빨라요. AMD 그래픽카드 지원은 아직 제한적이에요
비용무료(MIT). 모델도 앱 안에서 받아요. VIP 코드로 여는 모델이 따로 있지만, 후원하지 않아도 코드를 받을 수 있다고 앱 안내에 적혀 있어요
시작하기
- 설치 파일 받기
윈도 10 이상은 Releases의 UVR_v5.6.0_setup.exe 를, 맥은 M1(arm64)용과 인텔(x86_64)용 dmg 중 맞는 것을 받아요. AMD 라데온이나 인텔 아크 그래픽카드라면 DirectML 버전을 써 볼 수 있어요. 윈도에서는 꼭 C 드라이브에 설치하라고 해요. 다른 드라이브는 불안정하다고 적혀 있어요.
- 맥에서 열리지 않을 때
애플 보안 때문에 열리지 않으면 README가 터미널 명령을 안내해요. 아래 줄은 UVR 앱에 붙은 격리 표시만 지워요. README의 다른 한 줄(spctl)은 맥 전체 설정을 바꾸니 주의할 점을 먼저 읽어 주세요.
sudo xattr -rd com.apple.quarantine /Applications/Ultimate\ Vocal\ Remover.app - 처음 실행은 기다리기
맥에서는 처음 켤 때 기종에 따라 5~10분까지 걸릴 수 있다고 해요.
- 모델 받기
Start Processing 왼쪽의 설정 버튼에서 다운로드 센터를 열고 쓸 모델을 받아요.
- 노래 넣고 돌리기
Select Input 으로 노래를, Select Output 으로 저장 폴더를 고르고 처리 방식과 모델을 정한 뒤 Start Processing 을 눌러요. 처음엔 Sample Mode 로 짧게 비교해 보세요.
- 리눅스는 직접 설치
데비안, 아치 계열 안내가 README에 있어요. 저장소를 받아 가상 환경을 만들고 pip install -r requirements.txt 로 부품을 깐 뒤 실행해요.
python UVR.py
처리 방식을 고르면 이런 파일이 나와요
내노래.mp3음악/분리UVR 화면과 앱 안의 진행 문구, 저장 파일 이름 규칙을 따라 저희가 그린 예시예요. 파형은 실제 소리가 아니고, 걸리는 시간과 분리 품질은 노래, 모델, 컴퓨터 성능에 따라 달라져요.
비슷한 도구
UVR은 분리 하나에 집중한 앱이에요. 아래 둘은 다른 일을 하면서 분리를 한 단계로 쓰는 도구예요(각 README 기준).
주의할 점
- 남의 노래를 나눠 만든 반주나 목소리도 원곡의 권리(작사, 작곡, 실연, 음반)가 그대로 남아 있어요. 혼자 연습하는 것과 영상에 넣어 공개하는 것은 달라요. 공개하려면 권리자 허락이나 올릴 플랫폼의 음원 사용 규정을 먼저 확인하세요.
- README가 맥에서 안내하는 sudo spctl --master-disable 은 출처를 가리지 않고 모든 앱 실행을 허용하는 맥 전체 설정이에요. README도 UVR이 열린 뒤 다시 켜라고 권하니, 쓴 뒤에는 sudo spctl --master-enable 로 되돌려 두세요.
- 지금 받는 5.6은 2023년 9월에 나온 버전이에요. 10월 6일 개발 소식에서 만든 사람은 2023년 이후 나온 새 모델들과의 호환을 UVR 6에서 손보는 중이라고 밝혔어요.
- 윈도 7 이하, 인텔 펜티엄·셀러론, 오래되거나 저가형 맥에서는 동작을 보장하지 않는다고 적혀 있어요. WAV가 아닌 파일은 FFmpeg가, 속도와 키 바꾸기는 Rubber Band가 있어야 돌아가요.
- UVR 모델을 자기 앱에 넣어 쓰는 개발자에게는 MIT 라이선스에 따라 UVR과 개발자 이름을 밝혀 달라고 README가 요청해요.
더 보기
핵심 개발자는 Anjok07과 aufr33이에요. VR Architecture는 tsurumeso, MDX-Net은 Kuielab과 Woosung Choi, Demucs는 facebookresearch의 Adefossez가 만든 코드에서 출발했다고 README가 밝혀요.
설치 파일(v5.6 릴리스) ↗UVR 6 개발 소식(이슈 2399) ↗AMD 그래픽카드용 브랜치 ↗깃허브 저장소 ↗
낯선 말
- 음원 분리 · 섞여 있는 노래에서 목소리, 악기 같은 소리 갈래를 따로 떼어 내는 일이에요
- 스템 · 분리해서 나온 소리 갈래 하나예요. 목소리 스템, 드럼 스템처럼 불러요
- MR · 가수 목소리를 뺀 반주만 있는 음원을 흔히 부르는 말이에요
- 앙상블 · 여러 모델의 결과를 합쳐 하나의 결과를 만드는 방법이에요
- 스펙트로그램 · 소리를 시간과 높낮이(주파수)로 펼쳐 그린 그림이에요. 분리 모델은 이 그림에서 목소리 부분을 찾아요
- Segment 크기 · 한 번에 계산하는 소리 조각의 크기예요. 작으면 메모리를 덜 쓰고, 크면 더 쓰지만 결과가 나을 수 있어요
- 반음 · 피아노 건반 한 칸만큼의 음 높이 차이예요. 키를 바꿀 때 이 단위로 올리고 내려요
댓글
AI 답은 참고 자료예요. 법·세금·돈·건강처럼 삶에 큰 영향을 주는 일에서는 AI 답이 정답이 될 수 없어요. 최종 판단은 전문가나 공식 기관에서 확인하세요.

